概要
この度14年間務めた株式会社サイバーエージェントを退職し、株式会社カナリーへ転職いたしました。
サイバーエージェント
サイバーエージェントでは
ブラウザゲーム:ペコロッジ
↓
ネイティブゲーム:ミリオンチェイン
↓
音楽配信:AWA
↓
動画配信:ABEMA
↓
広告配信:AJA
と経験させて頂きました。
カナリー
早速ですが、カナリーで登壇いたします。興味のある方は是非ご参加ください。
この度14年間務めた株式会社サイバーエージェントを退職し、株式会社カナリーへ転職いたしました。
サイバーエージェントでは
ブラウザゲーム:ペコロッジ
↓
ネイティブゲーム:ミリオンチェイン
↓
音楽配信:AWA
↓
動画配信:ABEMA
↓
広告配信:AJA
と経験させて頂きました。
早速ですが、カナリーで登壇いたします。興味のある方は是非ご参加ください。
OpenTelemetry(以下 OTel)で独自の属性や span を足していくと、命名ルールが無いため名前がバラバラになりがちです。
たとえば次のようなことが起きます。
| 起きること | 例 | 困ること |
|---|---|---|
| 標準の名前空間に独自キーが混ざる | 独自のリクエスト ID を http.request_id で付ける |
将来 semconv が同じ名前を別の意味で定義すると衝突する |
| 同じ概念のキーが分裂する | checkout.order_id と payment.orderId |
「この注文のトレース」をサービス横断で検索できない |
| 同じキーで型が混ざる | order.id に "123" と 123 が混在 |
絞り込みや集計が壊れる |
semconv を活用しつつ、独自属性と span 名の命名ルールを決めた際のメモです。
分散トレースとログの統合を調べた際に、次のような 3 つのイベント概念があります。
この記事ではこれらの違いについて説明します。
まず先にspanとeventの違いを説明します。
| 記録したいもの | 置き場 |
|---|---|
| 区間と境界がある操作 | span |
| 操作全体の性質で、独自の時刻が不要 | span 属性 |
| 名前の付いた時点の出来事 (その時刻・severity・属性が要る) |
event(EventName 付き LogRecord) |
| 名前で引かない診断メッセージ | 普通の LogRecord |
例えば同じ cache miss でも、回数だけなら span 属性、その回の時刻や cache.key が要るなら event です。
wide event は、回数のように操作全体で足りる情報を span 属性として広げる手法です。
続きを読む従来の三本柱(ログ・メトリクス・トレース)と呼ばれる Observability 1.0 と、Honeycomb が提唱する Observability 2.0 の違いを説明します。
Honeycombは日本ではあまり知名度は高くないですが、2022年からGartnerでリーダーやビジョナリーとして上位に格付けされています。
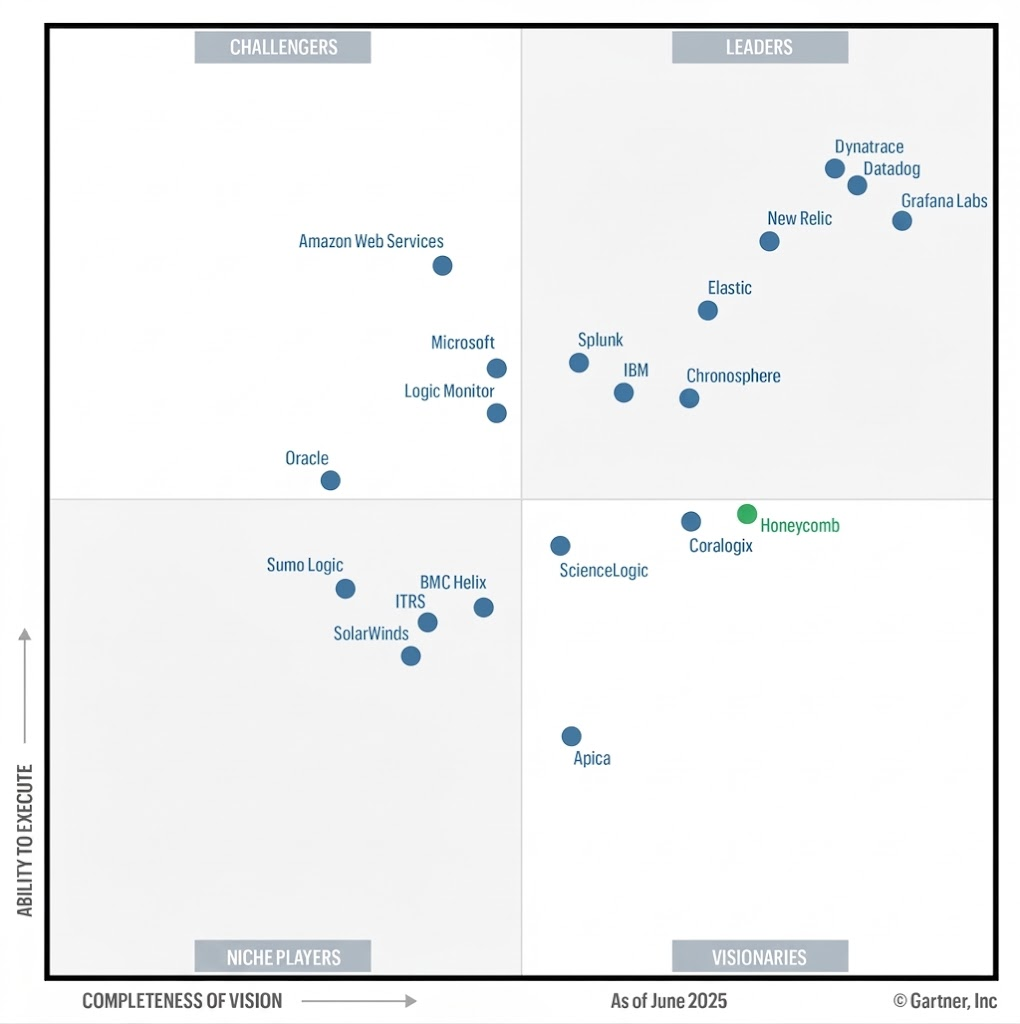
その Honeycomb が提唱する Observability 2.0 は、「ドメイン知識が無くても異常を検知するにはどうすればいいか?」という課題にフォーカスし、従来の Observability の概念とは異なるアプローチで解決します。
続きを読むCloud Spanner の Go クライアント(cloud.google.com/go/spanner)には読み取り方法が 3 つあります。
用語がぱっと頭に浮かぶよう、API の差と、問題が発生するケースをまとめます。
過去にトランザクション分離レベルについてまとめたことがあり、そちらの知識があるとより理解しやすいです。
| client.Single() | client.ReadOnlyTransaction() | client.ReadWriteTransaction() | |
|---|---|---|---|
| 分離レベル | クエリごとのスナップショット | スナップショット分離 | 直列化可能 |
| BeginTransaction RPC | 発行しない。クエリに TransactionSelector_SingleUse を同梱する |
発行する | 通常は不要。最初のステートメントに TransactionSelector_Begin をインラインする |
| 追加ラウンドトリップ | 0 | +1 | 0(初回文が失敗した場合などは、フォールバックで明示 begin) |
| 読み取り回数 | 1 回のみ | 複数可 | 複数可 |
| スナップショット | クエリごとに独立 | begin 時の read timestamp で固定 | ロックあり |
Close() |
不要 | 必須 | 不要。コールバック終了で完結する |
ざっくりまとめると以下の方針で使うと良いです。
Single()ReadOnlyTransaction()ReadWriteTransaction()Datadog のカスタムメトリクス費用が高くなりやすいので、何が課金対象になるかを整理したメモです。
「細かく切り分けて見たい」とタグを足すと、課金対象の時系列が急増します。
たとえば「注文数」という指標が 1 種類でも、店舗別・決済手段別・ホスト別に記録すると、数万〜数十万系列になりコストが爆増します。
カスタムメトリクスは、CPU 使用率などの標準監視だけでは分からない、自社アプリや業務の状態を数値化する用途で使います。
| 用途 | メトリクスの例 | 切り分けに使うタグの例 |
|---|---|---|
| 業務が正常に動いているか | 注文数、決済失敗数 | 決済手段、ステータス |
| アプリ内部の性能 | キャッシュヒット数、独自処理の実行時間 | キャッシュ名、処理名 |
| バッチ・非同期処理 | 処理件数、失敗数、最終成功からの経過時間 | ジョブ名、キュー名 |
| データの健全性 | 未処理件数、欠損件数、データ到着遅延 | データソース、テーブル |
| 業務上の異常検知 | 売上額、在庫数 | 店舗、商品区分 |
自分でコードを書いて送るものだけでなく、ログや APM の Span から生成したメトリクス、Prometheus / OpenMetrics 経由で収集する指標もカスタムメトリクスになり得ます。
続きを読むオブザーバビリティ環境を整備する中で、Go で Google Cloud Logging と Cloud Trace のログとトレースを紐付けることで横断調査しやすいよう対応した際のメモです。
Cloud Logging にはいくつかの予約フィールドがあります。
その中で次のフィールドを設定すると、Cloud Logging と Cloud Trace の関連付けができます。
| JSON キー | 中身 |
|---|---|
logging.googleapis.com/trace |
projects/<PROJECT_ID>/traces/<TRACE_ID>(TRACE_ID 単体でも可) |
logging.googleapis.com/spanId |
16 桁 hex(例: 000000000000004a) |
logging.googleapis.com/trace_sampled |
true / false |
